
애플이 2026년형 Mac mini에 M6와 M5 Pro를 넣으면서 제품의 쓰임새를 꽤 노골적으로 바꿨습니다. 예전에는 작고 조용한 데스크톱이라는 설명이 앞섰다면, 이번에는 아예 24시간 켜 두는 에이전트용 컴퓨터를 이야기합니다. 로컬 AI에 관심이 있는 사람이라면 귀가 솔깃할 만합니다.
다만 ‘AI 성능 최대 4배’라는 숫자만 보고 클라우드 AI를 전부 끊어도 된다고 생각하면 곤란합니다. 애플이 공개한 수치는 특정 비교 대상과 작업에서 나온 결과이고, 로컬 LLM은 칩 이름보다 통합 메모리 용량과 실행할 모델의 크기에 먼저 막힙니다. 일단 발표 문구와 실제 구매 판단을 분리해서 보겠습니다.
M6 Mac mini에서 실제로 달라진 것
M6는 12코어 CPU와 12코어 GPU를 갖추고, GPU 각 코어에 Neural Accelerator가 새로 들어갔습니다. Neural Engine도 ‘Dual 16-core’ 구조로 바뀌어 애플 기준 이전 세대보다 최대 2배의 피크 연산 성능을 냅니다. 기본 통합 메모리는 16GB이고 24GB 또는 32GB로 올릴 수 있으며, 상위 메모리 구성의 대역폭은 최대 170GB/s입니다.
M5 Pro 모델은 성격이 다릅니다. 기본 메모리부터 24GB이고 최대 64GB, 메모리 대역폭은 307GB/s입니다. 큰 모델을 메모리에 올리거나 처리량을 우선한다면 M5 Pro를 비교할 이유가 생깁니다. 그래서 M6의 최고 옵션과 M5 Pro 기본형을 가격만 놓고 비교하면 판단이 꼬이기 쉽습니다. 필요한 메모리 용량을 먼저 정한 뒤 칩을 골라야 합니다.
| 구분 | M6 | M5 Pro | 로컬 AI에서 보는 지점 |
|---|---|---|---|
| 통합 메모리 | 16GB, 24GB, 32GB | 24GB, 48GB, 64GB | 불러올 수 있는 모델 크기와 긴 대화 여유 |
| 메모리 대역폭 | 최대 170GB/s | 307GB/s | 모델이 메모리에 올라간 뒤의 처리 속도 |
| GPU | 12코어, 코어별 Neural Accelerator | 최대 20코어, 코어별 Neural Accelerator | 지원 프레임워크의 행렬 연산과 생성 작업 |
| 어울리는 용도 | 개인용 로컬 모델, 자동화, 일반 작업 병행 | 더 큰 모델, 긴 문맥, 무거운 제작 작업 | 모델 하나의 최고 성능보다 실제 운용 방식 |
‘AI 성능 4배’는 답변 전체가 4배 빨라졌다는 뜻이 아닙니다
여기가 이번 발표에서 가장 헷갈리는 대목입니다. 애플은 M6 Mac mini가 M4 모델보다 AI 작업에서 최대 4배 빠르다고 설명했고, 별도의 LM Studio 시험에서는 LLM 프롬프트 처리 성능이 최대 4.8배 빨라졌다고 밝혔습니다. 긴 문서나 긴 프롬프트를 모델에 넣었을 때 입력을 읽어 들이는 구간이 크게 빨라졌다는 뜻입니다.
반대로 답변을 한 토큰씩 만들어 내는 생성 속도가 언제나 4배 빨라진다는 자료는 아닙니다. 사용한 모델, 양자화 방식, 문맥 길이, 앱이 새 가속기를 얼마나 활용하는지에 따라 체감은 달라집니다. 일부 비교 글에서 보이는 ‘출력 생성은 1.19배’라는 수치도 애플 공개 자료에서는 확인되지 않습니다. 숫자가 없는 부분을 그럴듯하게 메우기보다는, 실제 제품이 나온 뒤 같은 모델과 설정으로 잰 독립 벤치마크를 기다리는 편이 맞습니다.
Neural Engine 코어 수만 보고 Ollama나 LM Studio가 같은 비율로 빨라진다고 단정할 수도 없습니다. 앱과 모델 실행 엔진이 GPU, Neural Engine, CPU 가운데 무엇을 어떤 비율로 쓰는지가 다르기 때문입니다. 이번 세대에서 확인된 것은 GPU 코어별 Neural Accelerator와 더 빠른 메모리가 추가됐고, 애플이 LM Studio의 프롬프트 처리에서 큰 차이를 측정했다는 데까지입니다.
32GB면 어느 정도 모델까지 가능한가
모델 이름보다 먼저 봐야 할 것은 내려받는 파일의 실제 크기입니다. 4비트 양자화 모델은 대략 파라미터 수의 절반에 가까운 저장 공간을 차지하지만, 실행할 때는 모델 파일만큼만 메모리를 쓰는 것이 아닙니다. macOS와 앱, KV 캐시, 긴 문맥, 동시에 띄운 도구가 같은 통합 메모리를 나눠 씁니다.
- 16GB: 7B~8B급 4비트 모델을 시험하고 짧은 자동화를 돌리는 입문용입니다. 브라우저와 개발 도구를 함께 많이 띄우면 금방 빠듯해집니다.
- 24GB: 8B~14B급 4비트 모델과 일반 작업을 함께 쓰기 수월합니다. 개인 문서 분류, 요약, 간단한 코딩 보조처럼 작은 모델이 잘하는 일을 상시 맡기기 좋습니다.
- 32GB: 14B급의 문맥을 넉넉히 잡거나 20B~30B대의 일부 4비트 모델을 조심스럽게 시험할 여지가 생깁니다. 다만 모델마다 구조와 메모리 사용량이 달라 ‘32GB면 32B까지 보장’이라고 외울 수는 없습니다.
- 48GB·64GB: 이 용량이 필요하다면 M5 Pro 영역입니다. 더 큰 모델과 긴 문맥, 여러 AI 작업을 동시에 유지하는 목적이 분명할 때 선택할 만합니다.
DeepSeek나 Kimi처럼 서비스 이름만 보고 판단하면 더 헷갈립니다. 같은 이름 아래에도 작은 증류 모델과 수백억·수천억 파라미터 원본 모델이 함께 있기 때문입니다. 다운로드 화면에서 파라미터 수, 양자화 표기, 파일 크기를 확인해야 합니다. 수백 GB 메모리를 요구하는 원본 대형 모델은 32GB Mac mini 한 대의 대상이 아닙니다.
추천 사양은 24GB·512GB, 단 조건이 있습니다
로컬 AI를 궁금해서 시작하고, Mac을 일상 컴퓨터와 자동화 허브로 함께 쓸 생각이라면 M6 24GB 통합 메모리와 512GB SSD가 가장 균형이 좋습니다. 16GB보다 실행 중 여유가 분명하고, 32GB 최고 구성까지 올렸다가 M5 Pro 기본형과 가격 차이가 애매해지는 일을 피할 수 있습니다.
다만 저장 공간은 생각보다 빨리 찹니다. 10GB 안팎 모델 몇 개, 개발 도구, 컨테이너와 작업 파일을 쌓으면 256GB는 금세 답답해집니다. 모델 파일을 외장 SSD로 옮길 수는 있지만 매번 연결해야 하고, 여러 도구가 기본 경로를 제각각 쓰기 때문에 관리가 번거롭습니다. 처음부터 512GB를 잡는 이유입니다.
반대로 아래에 해당하면 추천이 달라집니다.
- 작은 모델 한두 개를 맛보는 정도라면 16GB 기본형으로도 시작할 수 있습니다.
- 30B대 모델, 긴 문맥, 이미지 생성까지 자주 돌린다면 M6 32GB보다 M5 Pro 48GB 또는 64GB를 먼저 비교합니다.
- 수백억 파라미터 이상의 큰 모델이 주목적이라면 Mac mini 한 대에 예산을 몰기보다 M5 Ultra Mac Studio나 여러 Mac을 묶는 구성을 따로 계산해야 합니다.
24시간 켜 두기 좋다는 말과 전기요금은 구분해야 합니다
Mac mini를 자동화 허브로 보는 이유는 작고 조용하며, 화면 없이도 원격으로 운용하기 쉽기 때문입니다. 애플도 이번 제품을 상시 가동하는 에이전트용 데스크톱으로 직접 소개했습니다. 한국 제품 사양에 적힌 표준 연간 소비전력은 A3534가 12.8kWh, A3535가 16.5kWh이고 슬립 모드는 각각 0.9W와 0.8W입니다.
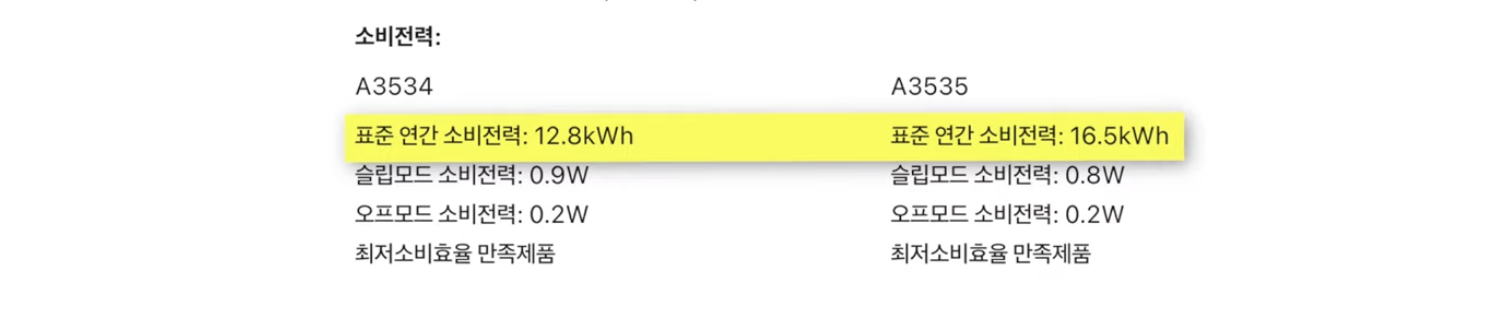
여기서 표준 연간 소비전력을 24시간 AI 서버의 예상 전기요금으로 그대로 쓰면 안 됩니다. 정해진 사용 시나리오에 따른 인증 수치이지, GPU를 계속 사용하는 실제 추론 부하를 측정한 값은 아니기 때문입니다. 상시 운용을 계획한다면 본인이 쓸 모델을 하루 정도 돌린 뒤 콘센트형 전력계로 평균 소비전력을 재는 방법이 가장 정확합니다.
클라우드 AI 구독을 끝낼 수 있을까
일부는 가능합니다. 문서에서 개인정보를 밖으로 보내고 싶지 않은 작업, 반복 분류, 짧은 요약, 정해진 형식으로 고치는 일은 작은 로컬 모델로 옮기기 좋습니다. 네트워크가 끊겨도 돌아가고 호출 횟수마다 비용이 붙지 않는다는 장점도 있습니다.
하지만 최신 대형 모델의 추론 능력, 방대한 문맥, 웹 검색과 멀티모달 기능까지 32GB Mac mini 하나로 그대로 대체하기는 어렵습니다. 현실적인 구성은 로컬 모델이 자료 정리와 단순 작업을 맡고, 어려운 판단만 클라우드 API로 보내는 방식입니다. 이 경우 Mac mini는 ‘클라우드를 없애는 상자’라기보다 클라우드 호출을 줄이고 개인 자동화를 계속 돌려 주는 본진에 가깝습니다.
결국 무엇을 사야 하나
처음부터 거대한 모델 한 개를 돌리는 것이 목적이라면 M6 Mac mini는 맞지 않습니다. 그러나 8B~14B급 로컬 모델을 일상 작업에 붙이고, 밤에는 분류나 요약 같은 자동화를 돌리며, 어려운 일만 API에 맡길 생각이라면 M6 24GB·512GB 구성이 설득력 있습니다.
32GB를 고르기 전에 한 번만 더 계산해 봅니다. 필요한 것이 단순히 메모리 8GB 추가인지, 더 넓은 307GB/s 대역폭과 최대 64GB 메모리까지 확장할 수 있는 M5 Pro인지 말입니다. 이번 세대는 ‘M6가 새 칩이니까 무조건 위’가 아닙니다. 작은 모델과 구입 비용의 균형은 M6, 더 큰 메모리와 대역폭은 M5 Pro로 용도가 갈립니다.